
Digitalización y reedición de fondos
Revistas históricas, boletines, actas, colecciones agotadas, catálogos… Muchas instituciones y editoriales guardan un fondo valioso que hoy nadie puede leer, buscar ni citar, porque solo existe en papel o en PDF de imagen.
Lo recuperamos y lo volvemos a publicar: en la web, en PDF de archivo, en ePub o en papel.
El proceso
- Imagen. Partimos del escaneado del original o de los PDF que ya existan, y fijamos con usted la calidad de imagen que necesita cada uso (archivo, web, impresión).
- Texto. Reconocimiento óptico de caracteres (OCR) y corrección cotejada con la imagen. El OCR automático deja errores que un corrector ortográfico no ve —cifras, nombres, cursivas, notas fuera de su sitio—; los corregimos respetando la ortografía de la época.
- Estructura. Marcamos el texto en XHTML con un vocabulario coherente para todo el fondo: números, secciones, artículos, autores, notas, páginas del original. Cada artículo y cada párrafo tiene un identificador estable, para poder enlazarlo y citarlo.
- Ilustraciones. Recortamos las imágenes, grabados, gráficos y tablas del original y los tratamos digitalmente —enderezado, limpieza, ajuste de tono y resolución— para reutilizarlos en las mejores condiciones en las nuevas ediciones.
- Publicación. De ese texto salen todas las ediciones (ver abajo).
- Controles. Comparamos automáticamente el OCR con el texto corregido para que no falte ni sobre nada, y comprobamos cada formato en varios lectores y visores.
Qué puede obtener
- Visor web: la imagen del original junto al texto corregido, con búsqueda en todo el fondo, índice de números y artículos, y enlaces a cada artículo, página y párrafo.
- PDF de archivo (PDF/A): la imagen en alta calidad con el texto corregido debajo, para buscar y copiar; marcadores por número y artículo; metadatos.
- PDF ligero para descargar desde la web.
- Reedición en ePub y en papel (impresión bajo demanda), con el texto compuesto de nuevo y las ilustraciones recuperadas.
- Los ficheros maestros en XHTML: el texto estructurado, listo para bases de datos, repositorios o herramientas de búsqueda con inteligencia artificial.
Un formato abierto, fácil de llevar a otros estándares
El XHTML es XML, así que el texto marcado puede convertirse de forma directa a otros esquemas y estándares: JATS, el habitual en revistas científicas y repositorios; TEI, el de las ediciones académicas de textos históricos; o el que pida su plataforma o biblioteca digital. Lo difícil —un texto correcto y bien estructurado— ya está hecho.
Para quién
Fundaciones, academias y asociaciones con publicaciones históricas; editoriales con fondo agotado; universidades, centros de investigación, archivos y bibliotecas.
Casos
Catálogo editorial de la Residencia de Estudiantes
- El fondo
- La práctica totalidad del catálogo editorial de la Residencia de Estudiantes, a partir de originales en papel o en PDF.
- El trabajo
- Digitalización y marcación semántica en XHTML de todo el contenido.
- El resultado
- Nuevos PDF interactivos, ePub 3 para distribución en librerías y bibliotecas, y ficheros de metadatos ONIX.
Archivo de una revista pedagógica (1890-1936)
- El fondo
- La colección completa de una revista histórica, encuadernada por años, con notas, cursivas y versalitas, artículos que continúan de un número a otro y reseñas de revistas extranjeras.
- El trabajo
- OCR, corrección cotejada con la imagen, marcación en XHTML de cada número y artículo, y producción de un visor web, un PDF de archivo y un PDF ligero por volumen.
- El resultado
- En curso.
Una demostración
Boletín de la Sociedad Española de Excursiones, 1896
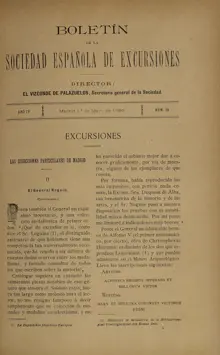
Un número completo de una revista de 1896, con grabados, láminas fuera de texto y una inscripción en árabe, procesado con el mismo método que aplicamos a los fondos de nuestros clientes: OCR corregido y cotejado con el original, marcación en XHTML de artículos, notas, figuras y láminas, y PDF con el texto corregido.
El visor muestra la imagen del original junto al texto corregido, con búsqueda, índice de artículos, vista de página y doble página, zoom y enlace a cada párrafo.
Original digitalizado: Dipòsit Digital de Documents de la Universitat Autònoma de Barcelona.